AI 重塑空间数据发现:RAG 与地理匹配破解 SDI 检索难题
每天,公共机构、研究所以及企业等数据提供者都在产生海量的空间数据。为了整合这些数据及其元数据并降低查找难度,地方、国家和国际层面纷纷建立了空间数据基础设施(SDI),元数据标准也逐步成熟并被广泛采用。然而,用户依然很难找到真正需要的数据集。 回想一下你上次寻找数据集的经历:你可能不得不访问多个地理门户或开放数据平台,每个平台都有各自的界面和布局。你输入几个关键词,祈祷它们能与元数据中的某个字段匹配。如果你用了同义词,那就更糟了——搜索“全球变暖数据集”未必能找到描述为“温室效应数据”的记录。如果元数据是德语、法语或其他语言,而你的搜索词是英语,成功率就更低了。即便关键词碰巧正确,你也很可能面对一个冗长且排序混乱的结果列表,不得不逐个打开检查是否相关。 如果你对这些困扰感同身受,你并不孤单。许多用户在真正使用数据之前,都要花费大量时间寻找数据。这就引出了本周的挑战:大语言模型(LLM)如何改善 SDI 中的数据发现? LLM 凭借其强大的语言处理能力而广受欢迎。你可能用过 ChatGPT、Gemini 或 Mistral 来解释概念、查找信息、翻译文本、生成代码甚至构建应用。它们的能力无疑令人印象深刻。那么,为什么不直接让 LLM 帮你找某个数据集呢? 遗憾的是,这并不能可靠地工作。LLM 将训练期间学到的知识存储在内部参数中,其内部知识在重新训练或更新之前是固定的。对于训练期之后发布的数据集,模型一无所知。现代 LLM 虽然具备互联网搜索工具,能找到热门、广泛使用的数据集,但 SDI 中的许多数据集存放在未被搜索引擎索引的目录中,因此对模型来说依然不可见。此外,让 LLM 查找覆盖特定区域的数据集,比如“汉堡的森林数据”,也会遇到困难。元数据通常用边界框坐标而非地名来描述数据集的空间范围,而 LLM 主要基于文本训练,并不擅长地理推理。除非数据集标题或描述中明确提到了地名,否则 LLM 很难将边界框坐标与你搜索时使用的地名对应起来。 简而言之,用 LLM 进行数据发现存在两个局限:知识过时或不完整,以及地理推理能力差。每次有新数据集发布或更新都重新训练或微调模型,既耗时又耗费资源。因此,更好的做法是:当用户提出请求时,让 LLM 即时访问 SDI 中最新的元数据。为避免上下文窗口过载,模型不会一次性访问所有信息,而是只访问与用户查询相关的子集。这种方法被称为检索增强生成(RAG)。
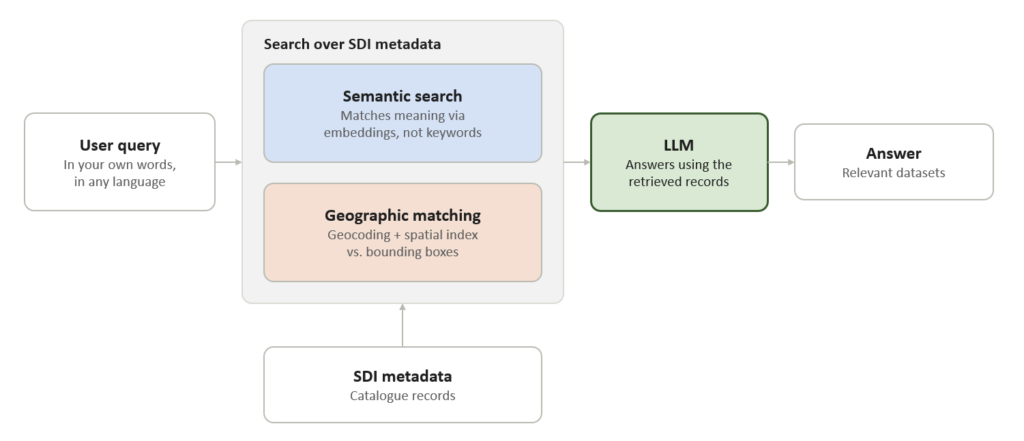
图 1 展示了系统的主要组件。第一个构建模块是语义搜索。数据集基于用户查询与元数据之间的相似性分析来检索,而非关键词的精确匹配。为此,用户查询和元数据记录都被转换为嵌入向量——编码文本含义的数字向量。含义相近的两个词即使没有任何共同词汇,在向量空间中也会彼此靠近。因此,搜索全球变暖数据可以找到关于温室效应的记录。你可以用自己的话描述想要的数据集,甚至可以使用与元数据不同的语言,系统也更有可能找到它。 但是,第二个问题——地理推理能力差——怎么办?嵌入向量擅长匹配语义,但并非为空间推理而构建。对它们来说,“明斯特”这个词和东经 7.6°、北纬 52.0° 附近的边界框毫无共同之处。这就需要地理匹配登场。地理编码将查询中提到的地名转换为坐标,空间索引则将这些坐标与元数据的边界框进行比较。只有范围与感兴趣区域相符的数据集才会进入结果列表。 最后,LLM 接收匹配的元数据记录,并用它们以自然语言回答用户查询。它不再仅仅依赖训练期间学到的知识,还可以对识别出的数据集重新排序,使其更贴合用户需求。
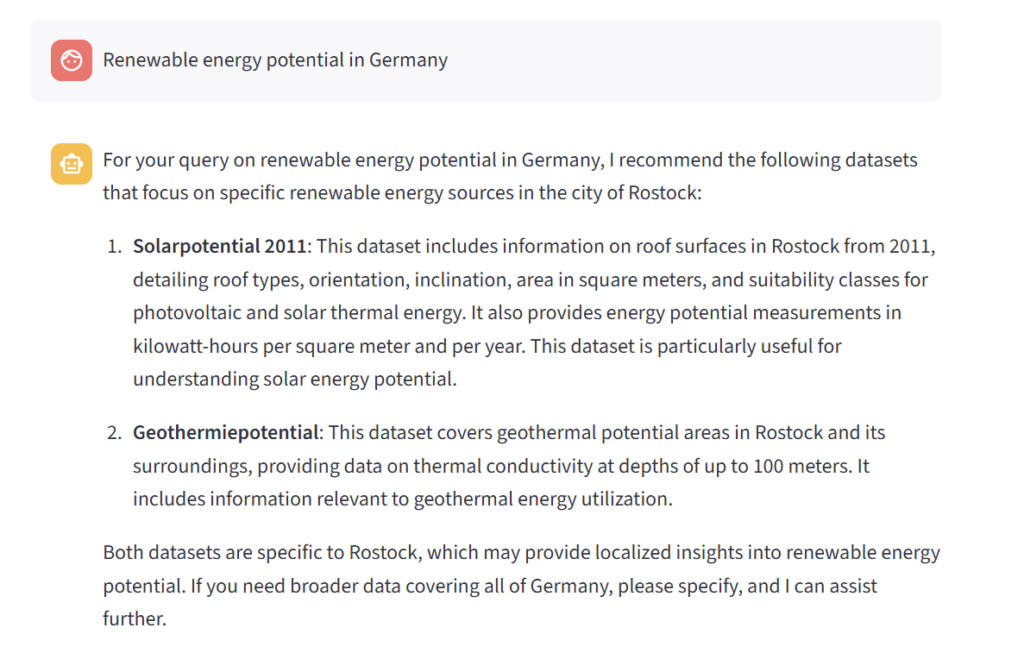
实际应用可能是这样的:你用英语询问“德国的可再生能源潜力”。语义搜索会找到与可再生能源相关的记录,包括元数据中提及“Solarpotential”和“Geothermiepotential”的数据集。地理匹配随后只保留边界框与德国重叠的数据集。你得到的不是冗长杂乱的列表,而是一份同时符合主题和区域的简短数据集清单(见图 2)。响应中还包含指向实际数据集的链接,你可以直接使用或进一步探索。 当然,这并非魔法棒。系统只能找到元数据所描述的内容。优质的元数据仍然是任何 SDI 或数据发现工作流的基础。糟糕或模糊的元数据会降低语义搜索和地理匹配的效果,导致数据集依然无法被发现。 想了解完整的技术细节和实现思路,请点击阅读原文。
编译自 Planet OSGeo,原文链接
原文摘要
Rethinking Spatial Data Discovery with AI
Exploring how Large Language Models can Improve Search in Spatial Data Infrastructures Every day, a huge amount of spatial data is produced by public agencies, research institutes, companies, and other data providers. Spatial Data Infrastructures (SDIs) have been set up at local, national and international levels to bring these data and its metadata together and make it easier to find. Metadata standards have matured and been adopted along the way. And yet, users still struggle to find the right datasets. Can you remember the last time you were looking for a dataset? Perhaps you had to visit several geoportals or open data portals, each with its own interface and layout. You typed a few keywords and hoped they matched something in the metadata. Woe unto you if you used a synonym! Searching for “global warming datasets” will not necessarily find a record described as “greenhouse effect data”. Your chances are even worse if you searched in English while the metadata was written in German, French or any other different language. And if you did get a keyword right, you probably faced a long, poorly ranked list of results and had to open each one and check whether it’s relevant. If you can relate to these frustrations, you are not alone. Many users spend a lot of time searching for data before they can use it. This brings us to this week’s challenge: How can Large Language Models (LLMs) improve data discovery in SDIs? LLMs have become popular thanks to their advanced language processing abilities. You have probably used ChatGPT, Gemini, or Mistral to explain a concept, find some information, translate text, generate code or even build an app. There is no doubt that their capabilities are impressive. So why not just ask an LLM to find a particular dataset? Unfortunately, that doesn’t work reliably. An LLM stores what it learned during training in its internal parameters. Its internal knowledge is fixed until the LLM is re-trained or updated, and until that happens, the m